


RAG, или Retrieval-Augmented Generation, — это способ заставить языковую модель отвечать с опорой на внешние источники: ваши документы, инструкции, базу знаний или другие данные. Перед ответом система находит материалы, относящиеся к вопросу, добавляет их в контекст модели и только после этого просит сформулировать ответ.
Главное отличие от обычного чата в том, что модели не нужно заранее «знать» содержание всех документов. Нужные сведения подбираются во время запроса. Поэтому базу можно обновлять отдельно от самой нейросети.
- Что такое RAG простыми словами
- Как RAG отвечает по вашим документам
- Что такое чанки и эмбеддинги
- RAG не обязательно означает только векторный поиск
- Чем RAG отличается от загрузки файла в чат и дообучения
- Почему RAG всё равно может ошибаться
- Отдельная проблема — права доступа
- Как проверить, что RAG действительно работает
- Когда RAG нужен, а когда можно обойтись без него
- Как RAG связан с ИИ-агентами
- Источники
- FAQ
- RAG обучает нейросеть на моих документах?
- Обязательно ли RAG нужна векторная база?
- Убирает ли RAG галлюцинации нейросети?
- Можно ли подключить RAG к закрытым документам компании?
- Чем RAG отличается от обычного поиска?
Что такое RAG простыми словами
Расшифровка RAG — Retrieval-Augmented Generation. Буквально это генерация, дополненная поиском. Вместо того чтобы просить языковую модель ответить только на основании знаний, полученных при обучении, система сначала даёт ей дополнительный материал, относящийся к текущему вопросу.
Логику можно представить как экзамен с открытой книгой. Обычная модель отвечает по памяти. В RAG-системе перед ответом ей находят несколько подходящих страниц и кладут перед ней. Модель читает вопрос вместе с найденными фрагментами и составляет из них понятный ответ.
Подход получил название RAG в работе Патрика Льюиса и соавторов Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, опубликованной в 2020 году. Исследователи объединили генеративную модель с отдельным механизмом поиска по внешнему индексу. Современные реализации могут заметно отличаться технически, но основной принцип сохранился: сначала получить подходящие сведения, затем использовать их при генерации.
Если нужно сначала разобраться, чем языковая модель отличается от нейросетей других типов, на Postolog есть отдельное объяснение что такое нейросеть и как она работает.
Как RAG отвечает по вашим документам
У типичной RAG-системы есть две разные задачи. Первая выполняется при подготовке базы знаний: документы нужно обработать так, чтобы по ним можно было искать. Вторая начинается после вопроса пользователя.
- Система получает документы. Это могут быть инструкции, справочники, страницы базы знаний, договоры, техническая документация или другие материалы, которые разрешено использовать.
- Текст делится на фрагменты. Такие части называют чанками. Они нужны потому, что при поиске обычно требуется не весь многостраничный файл, а несколько абзацев, которые отвечают на конкретный вопрос.
- Фрагменты индексируются. Для семантического поиска текст можно преобразовать в эмбеддинги — числовые представления, позволяющие сравнивать тексты по смысловой близости.
- Пользователь задаёт вопрос. Поисковый компонент ищет в базе наиболее подходящие фрагменты. Поиск может учитывать смысл, ключевые слова, метаданные, дату документа, права доступа и другие условия.
- Найденный материал добавляется к запросу. Языковая модель получает исходный вопрос и подобранный контекст.
- Модель формирует ответ. Если система сохраняет информацию об источниках, вместе с ответом можно показать документ или раздел, на который он опирается.
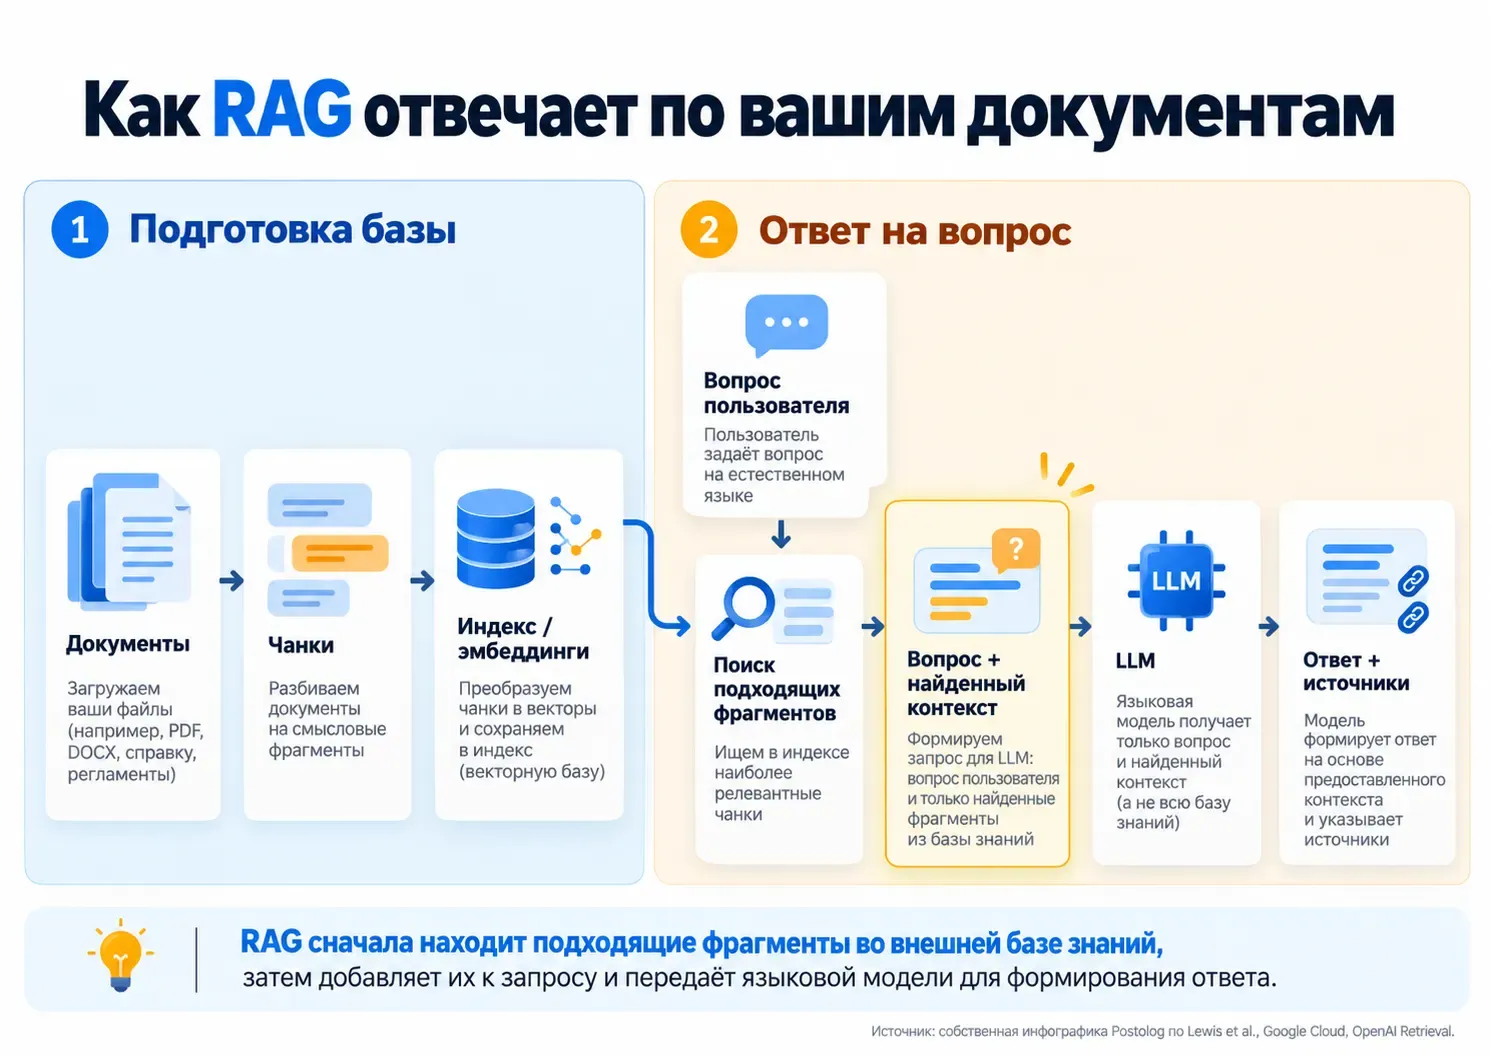
Google Cloud описывает этот процесс тремя словами: retrieve, augment, generate — найти сведения, дополнить ими запрос и сгенерировать ответ. Именно последовательность этих операций важнее конкретного продукта или базы данных.
Что такое чанки и эмбеддинги
Чанк — отдельный фрагмент исходного документа. Если загрузить длинную инструкцию как одну неделимую запись, поиску будет труднее точно определить, какая её часть отвечает на вопрос. Поэтому текст делят на меньшие смысловые участки.
Размер чанка не имеет одного правильного значения для всех проектов. Маленький фрагмент может потерять необходимый контекст, а слишком большой — принести в запрос много постороннего текста. Деление приходится проверять на реальных вопросах к конкретной базе.
Эмбеддинг — числовое представление содержания. Оно позволяет искать не только буквальные совпадения слов. Например, вопрос о сроке поставки может быть близок по смыслу к абзацу о времени доставки, хотя формулировки различаются.
В документации OpenAI Retrieval семантический поиск также описан как поиск смыслово близких результатов, даже когда в запросе и найденном фрагменте мало одинаковых слов. Файлы, добавленные в vector store, могут автоматически разбиваться на фрагменты, преобразовываться в эмбеддинги и индексироваться.
RAG не обязательно означает только векторный поиск
Слова Retrieval-Augmented Generation определяют общую схему, а не конкретный поисковый алгоритм. Главное, чтобы перед генерацией система получила подходящие внешние сведения.
Поэтому искать можно несколькими способами:
- по ключевым словам — хорошо работает для артикулов, точных названий, номеров документов и терминов;
- по смысловой близости — помогает находить фрагменты, сформулированные другими словами;
- гибридно — объединять несколько методов и затем пересортировывать найденные кандидаты.
Например, действующая документация OpenAI File Search прямо указывает на использование семантического и ключевого поиска по загруженной базе файлов. Поэтому формула «RAG = векторная база» слишком узкая: векторное хранилище может быть важной частью системы, но сама архитектура шире.
Чем RAG отличается от загрузки файла в чат и дообучения
Эти способы часто смешивают, хотя они решают разные задачи.
| Подход | Что происходит | Когда особенно уместен |
|---|---|---|
| RAG | Перед ответом система ищет релевантные сведения во внешней базе и добавляет их в контекст модели | Большая или регулярно меняющаяся база знаний, вопросы по документам, необходимость показывать источники |
| Документ в контексте | Текст файла целиком или частично передаётся модели вместе с запросом | Разовая работа с небольшим набором материалов, который помещается в доступный контекст |
| Fine-tuning | Изменяются параметры модели на обучающем наборе примеров | Настройка устойчивого поведения, формата или выполнения специализированной задачи |
Сама кнопка «загрузить файл» ещё ничего не говорит об архитектуре сервиса. Один продукт может передать документ модели целиком, другой — проиндексировать его и искать подходящие фрагменты, третий — сочетать несколько механизмов. Поэтому корректнее спрашивать не «можно ли загрузить PDF», а «как система выбирает информацию из него перед ответом».
RAG и fine-tuning тоже не являются взаимоисключающими технологиями. AWS рассматривает их как разные способы адаптации системы и отдельно отмечает, что их можно сочетать. Для вопросно-ответной системы по собственным меняющимся документам RAG позволяет обновлять внешнюю базу без повторного обучения самой модели.
Почему RAG всё равно может ошибаться
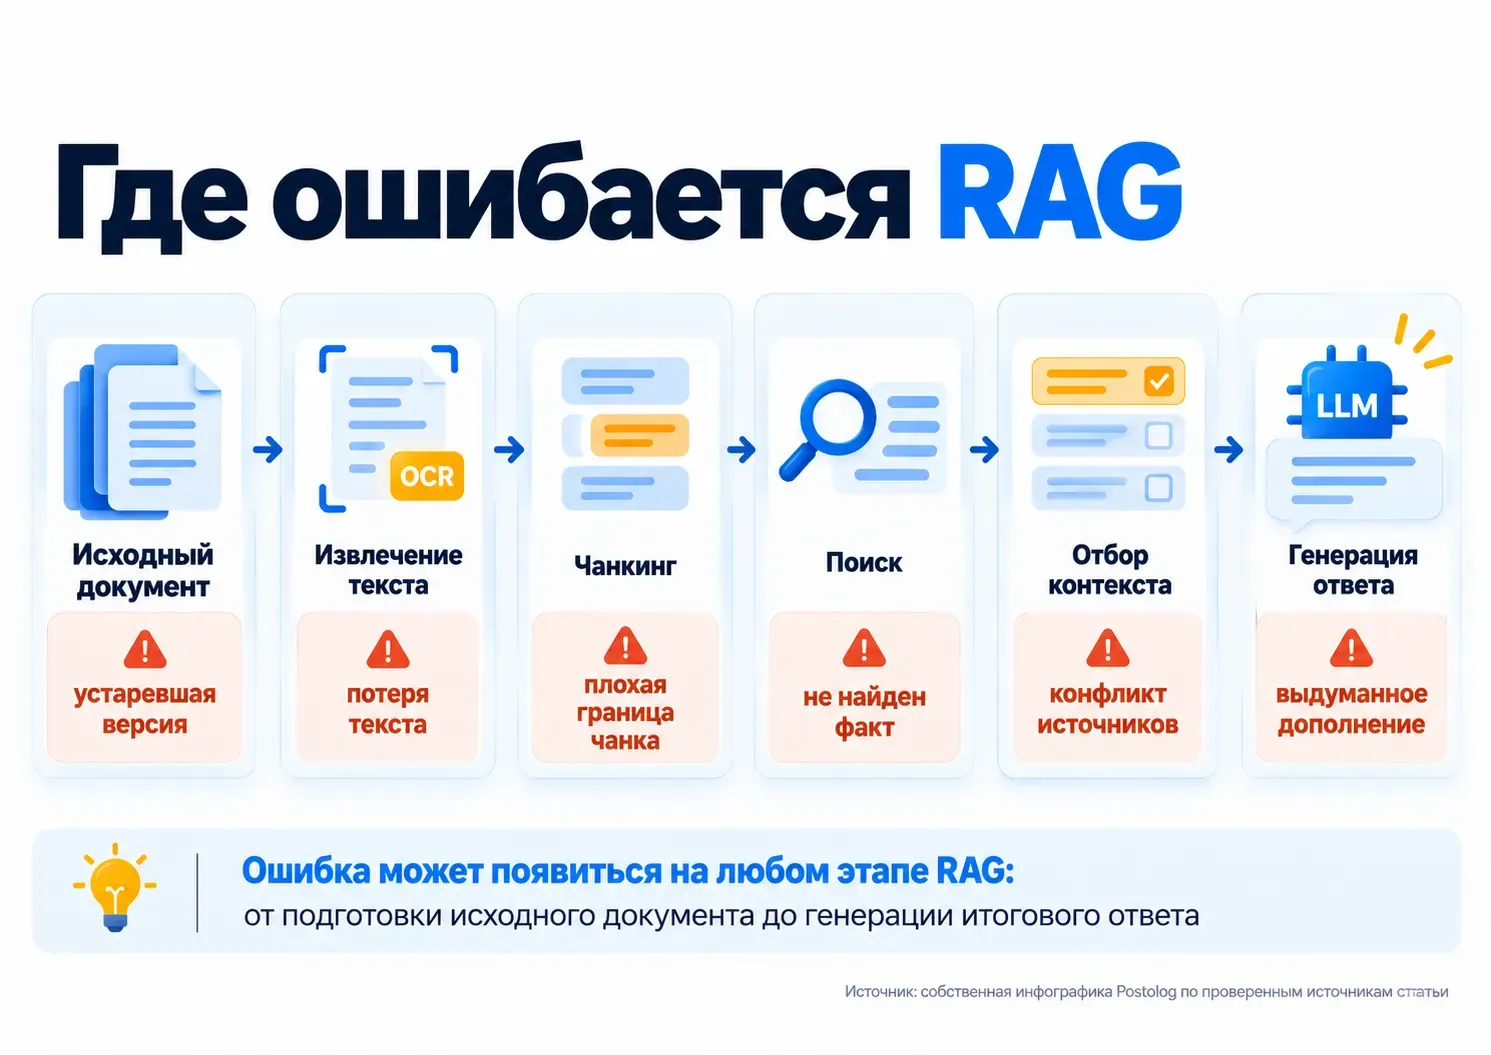
RAG даёт модели дополнительную опору, но не превращает её в безошибочный справочник. Ошибка может возникнуть ещё до этапа генерации.
- В базе неверные или устаревшие сведения. Модель может аккуратно пересказать документ, который уже не действует.
- Документ плохо обработан. При извлечении текста из скана, таблицы или сложного PDF часть содержания может потеряться.
- Не найден нужный фрагмент. Тогда модель получает неполный контекст и не видит сведения, необходимые для ответа.
- Найдены противоречащие друг другу версии. Без даты, версии и правил приоритета система может смешать старый документ с новым.
- Модель выходит за пределы найденных данных. Если приложение не требует признать отсутствие ответа, языковая модель может дополнить недостающую часть собственным предположением.
Поэтому корректная формулировка — RAG способен снизить риск фактических ошибок за счёт внешнего контекста, но не гарантирует достоверность каждого ответа. Качество нужно проверять отдельно для поиска и для итоговой генерации.
Отдельная проблема — права доступа
Если корпоративный поиск способен найти документ, это ещё не означает, что его содержание разрешено показывать конкретному пользователю. Права нужно учитывать на этапе retrieval, до передачи текста языковой модели.
Есть и другая причина не считать документы безусловно доверенными. Microsoft рекомендует относиться к извлечённым фрагментам как к недоверенному входу: в файле или веб-странице могут оказаться инструкции, способные повлиять на модель. Для корпоративной RAG-системы важны не только поиск и качество ответа, но и происхождение данных, разрешения и защита от таких инструкций.
Как проверить, что RAG действительно работает
Красивого ответа недостаточно. Для проверки подготовьте набор вопросов, в котором заранее известно, что система должна найти и чего она не должна показывать.
| Проверка | Что сделать | Как выглядит корректный результат |
|---|---|---|
| Факт есть в одном документе | Задать вопрос по конкретному действующему пункту | Ответ соответствует документу, источник определяется однозначно |
| Вопрос сформулирован другими словами | Не повторять лексику исходного текста | Поиск всё равно находит смыслово подходящий фрагмент |
| Ответа в базе нет | Спросить о сведении, которого документы не содержат | Система сообщает, что данных недостаточно, а не придумывает ответ |
| Есть старая и новая версии | Задать вопрос по изменённому правилу | Используется актуальная версия либо явно сообщается о конфликте источников |
| Документ закрыт для пользователя | Проверить вопрос по материалу с ограниченным доступом | Закрытые сведения не попадают ни в найденный контекст, ни в ответ |
Эта проверка разделяет две разные проблемы. Если нужного фрагмента среди результатов поиска нет, исправлять только промпт генератора недостаточно. Если поиск нашёл правильные данные, но итоговый ответ их исказил, проблема находится уже на следующем этапе.
Когда RAG нужен, а когда можно обойтись без него
RAG особенно уместен, когда ответы должны регулярно опираться на отдельный массив знаний: корпоративные регламенты, инструкции, документацию, справочники, каталоги или другие материалы, которые можно обновлять независимо от модели.
Он также подходит, когда важна проверяемость ответа. Если поисковый слой сохраняет источник каждого фрагмента, приложение может показать читателю документ, на основании которого сформирован вывод.
Не каждой задаче нужен RAG. Если требуется один раз пересказать небольшой документ, который целиком помещается в контекст, отдельный поисковый контур может оказаться лишним. Если задача состоит прежде всего в устойчивом изменении поведения модели, формата ответа или специализированного навыка, стоит отдельно рассматривать fine-tuning. AWS прямо разделяет эти сценарии и рекомендует выбирать метод по задаче, а не по сложности названия.
Как RAG связан с ИИ-агентами
RAG отвечает за получение знаний, а ИИ-агент решает более широкую задачу: он может выбирать действия, обращаться к инструментам и продолжать работу после получения результата. Поэтому RAG часто становится одним из инструментов агента, но не превращает обычный поисковый чат в агента автоматически.
Например, агент может сначала найти в базе правило оформления заявки, затем проверить данные пользователя и только после этого создать запись в рабочей системе. Поиск по документам отвечает на вопрос «что известно и какое правило применимо», а агентная логика — «что делать дальше». Подробнее этот второй механизм разобран в статье «ИИ-агенты: что это, как работают и зачем нужны бизнесу».
Если задача шире и нужно определить, какие рабочие процессы вообще стоит передавать искусственному интеллекту, смотрите разбор применения ИИ для автоматизации рабочих задач.
Источники
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks — исходная работа Lewis et al. 2020 года о Retrieval-Augmented Generation.
- Google Cloud: Generative AI glossary — определение RAG, grounding и схема retrieve → augment → generate.
- OpenAI: Retrieval — семантический поиск, эмбеддинги и vector stores.
- OpenAI: File Search — поиск по базе загруженных файлов с использованием semantic и keyword search.
- AWS: Comparing Retrieval Augmented Generation and fine-tuning — различия между RAG и дообучением и условия выбора подхода.
- Microsoft: Retrieval augmented generation and indexes — безопасность, контроль доступа и обработка извлечённого содержимого как недоверенного входа.
FAQ
RAG обучает нейросеть на моих документах?
Нет, в обычной RAG-схеме документы не становятся частью параметров языковой модели. Система находит нужные сведения во внешней базе и передаёт их модели вместе с текущим запросом. Поэтому изменение документа не обязательно требует переобучения модели.
Обязательно ли RAG нужна векторная база?
Нет. RAG описывает принцип «найти внешние сведения и использовать их при генерации», а не конкретный поисковый алгоритм. Можно использовать поиск по ключевым словам, семантический поиск или их сочетание. Векторные хранилища широко применяются для поиска по смысловой близости.
Убирает ли RAG галлюцинации нейросети?
Нет. Хороший retrieval даёт модели более надёжную опору и способен уменьшить риск выдуманного ответа, но ошибка всё равно возможна. Система может найти не тот документ, получить устаревшую версию, пропустить нужный фрагмент или неверно интерпретировать найденное.
Можно ли подключить RAG к закрытым документам компании?
Технически да, но сам RAG не обеспечивает конфиденциальность автоматически. Архитектура должна проверять права пользователя до передачи найденного текста модели, разделять разрешённые и закрытые источники и учитывать условия обработки данных выбранным сервисом.
Чем RAG отличается от обычного поиска?
Обычный поиск возвращает документы или фрагменты. RAG добавляет следующий этап: найденные сведения передаются языковой модели, которая формирует из них ответ на естественном языке. При этом качество результата по-прежнему зависит от качества самого поиска.


